https://www.examtopics.com/exams/nvidia/ncp-aii/view/2/
NCP-AII NVIDIA Exam - Free Actual Questions and Answers | ExamTopics
Create your free account Choose a nickname and verify your email to continue. ✔ Free account Create account Log in Check your email Enter the six-digit code to activate your account and continue to Questions 11-20. Your username Reserved ✔ Code sent We
www.examtopics.com
During HPL execution on a DGX cluster, the benchmark fails with “not enough memory” errors despite sufficient physical RAM.
Which HPL.dat parameter adjustment is most effective?
- A. Increase block size to 6144 to maximize GPU utilization.
- B. Reduce the problem size while maintaining the same block size.
- C. Set PMAP to 1 to enable process mapping.
- D. Disable double-buffering via BCAST parameter.
DGX 클러스터에서 HPL을 실행하는 동안 물리적 RAM 용량이 충분함에도 불구하고 "메모리 부족" 오류와 함께 벤치마크가 실패합니다.
어떤 HPL.dat 매개변수 조정이 가장 효과적일까요?
- A. GPU 활용도를 극대화하기 위해 블록 크기를 6144로 늘리십시오.
- B. 동일한 블록 크기를 유지하면서 문제 크기를 줄입니다.
- C. 프로세스 매핑을 활성화하려면 PMAP 값을 1로 설정하십시오.
- D. BCAST 매개변수를 통해 이중 버퍼링을 비활성화합니다.
정답은 B. Reduce the problem size while maintaining the same block size 입니다. ✅
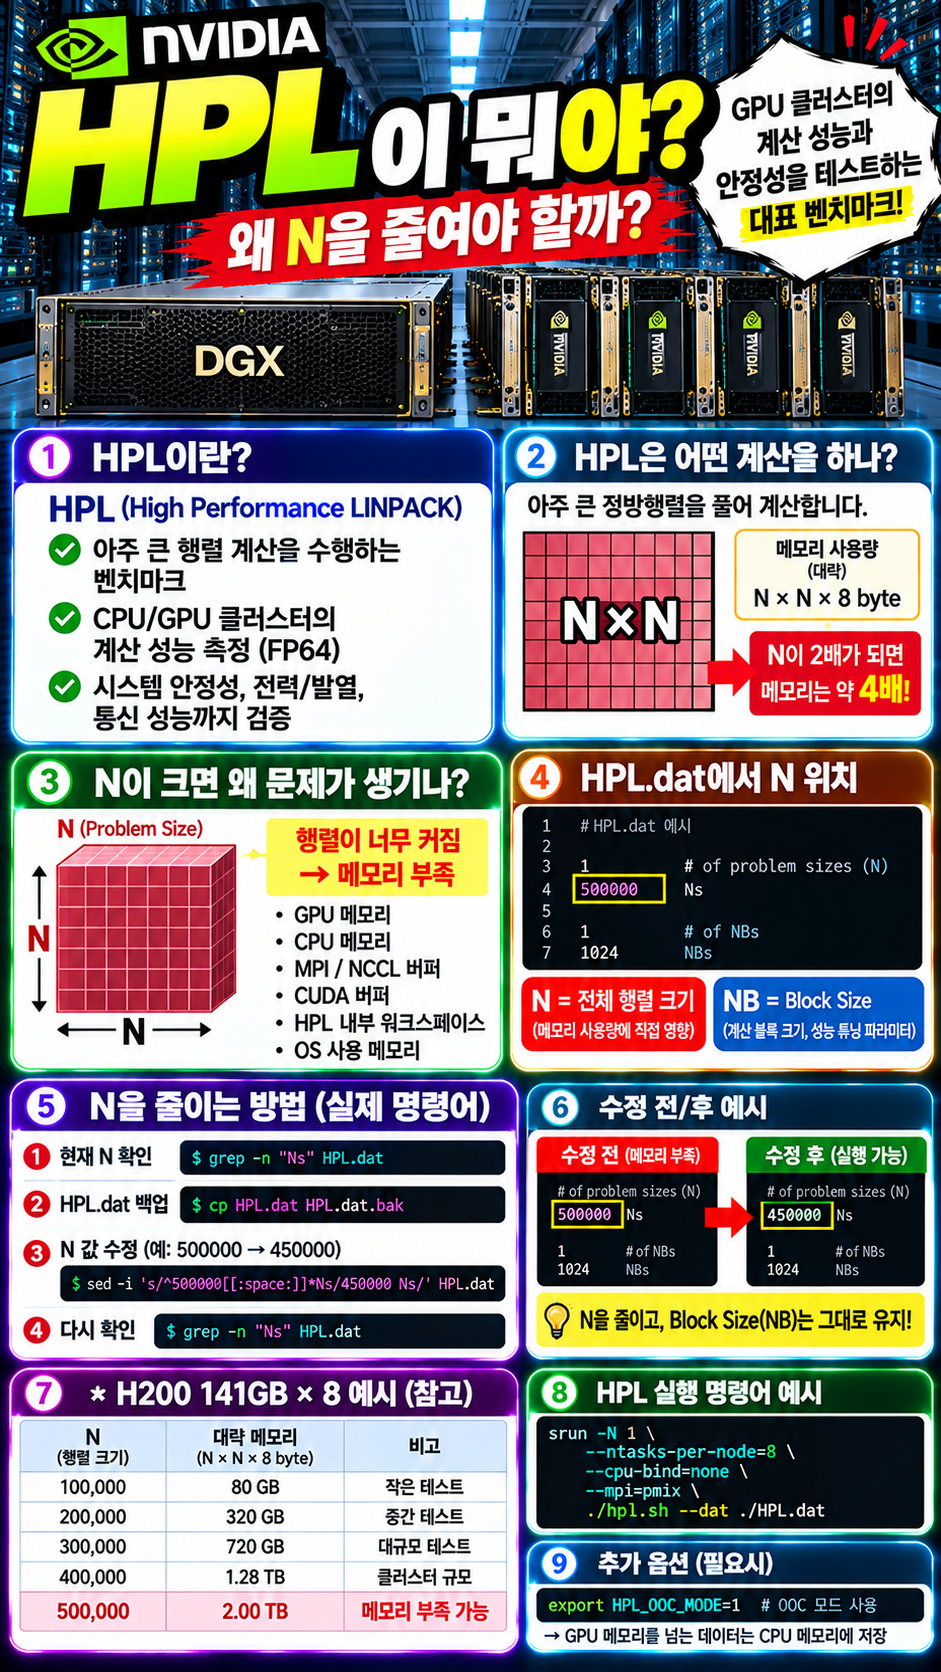
이 문제의 핵심은 HPL의 N(Problem Size) 이 메모리 사용량을 가장 크게 결정한다는 점입니다.
HPL은 큰 정방행렬을 메모리에 올려 계산하는데, 행렬 크기가 N × N이고 double precision은 원소당 8바이트를 사용합니다. 따라서 메모리 사용량은 대략 8 × N²에 비례합니다. HPL 공식 FAQ도 메모리 부족 시 가장 먼저 problem size N을 조절해야 한다고 설명합니다. Netlib
쉽게 이해하면
HPL.dat 안에는 이런 값이 있습니다.
1            # of problem sizes (N)
500000       Ns
1            # of NBs
1024         NBs
여기서:
- N = 500000 → 계산할 전체 행렬 크기
- NB = 1024 → 행렬을 나눠 처리하는 Block Size
입니다.
메모리가 부족하면:
N이 너무 큼
   ↓
행렬 자체가 너무 큼
   ↓
Memory 부족
   ↓
HPL 실패
따라서 N을 줄이는 게 가장 직접적인 해결책입니다.
N이 왜 그렇게 중요한가?
예를 들어:
N = 100,000이면 대략:
100,000 × 100,000 × 8 byte
≈ 80 GB
입니다.
그런데:
N = 200,000으로 2배 올리면 메모리는 2배가 아니라:
200,000² / 100,000²
= 4배
가 됩니다.
즉:
N은 2배 → 메모리는 약 4배
입니다.
이게 아주 중요한 시험 포인트입니다.
그런데 “RAM이 충분하다는데 왜 Memory Error가 나지?”
이 부분이 문제의 함정입니다.
서버 전체 RAM이 충분해 보여도 실제 HPL에서는:
- 각 MPI rank에 할당된 메모리
- GPU Device Memory
- OS가 사용하는 메모리
- Communication buffer
- HPL 내부 workspace
- CUDA/NCCL buffer
- NUMA별 사용 가능 메모리
등이 추가로 필요합니다.
예를 들어:
System RAM
2 TB

HPL Matrix
1.9 TB
라고 하면 숫자상으로는 맞아 보이지만:
OS
MPI
NCCL
CUDA
Buffers
가 사용할 공간이 없게 됩니다.
그래서 HPL에서는 전체 메모리를 100% 꽉 채우도록 N을 설정하지 않습니다.
Netlib HPL FAQ에서도 전체 메모리의 약 80% 정도를 사용하는 problem size를 시작점으로 삼는 것을 권장합니다. Netlib
✅ B가 정답인 이유
B:
Reduce the problem size while maintaining the same block size.
즉:
N ↓

NB 유지
입니다.
예를 들어 기존:
N  = 500000
NB = 1024
에서:
N  = 450000
NB = 1024
처럼 바꿉니다.
그러면:
전체 Matrix 크기 ↓
        ↓
Memory Usage ↓
        ↓
OOM 해결 가능
이 됩니다.
❌ A. Block Size를 6144로 증가
NB = 6144NB는 계산 granularity 및 데이터 분배 블록 크기와 관련됩니다.
즉 주로:
Performance tuning parameter
입니다.
N처럼 전체 행렬 메모리 크기를 결정하는 핵심 변수는 아닙니다.
오히려 block size를 크게 잡으면 추가 buffer나 효율 문제 때문에 상황이 더 나빠질 수도 있습니다.
따라서:
Memory 부족
↓
NB 증가 ❌

N 감소 ✅
로 기억하세요.
❌ C. PMAP = 1
PMAP은 MPI Process Grid의 mapping 방식과 관련된 설정입니다.
예:
P × Q Process Grid를 어떤 순서로 배치할 것인지 결정합니다.
즉:
Process 배치문제이지:
전체 Matrix Memory를 직접 줄이는 옵션이 아닙니다.
❌ D. BCAST로 Double Buffering 비활성화
BCAST는 HPL에서 panel broadcast 알고리즘을 선택하는 파라미터입니다.
즉:
MPI Communication 방식과 관련된 설정입니다.
전체 problem size 자체를 줄이지 않기 때문에 이 문제의 가장 직접적인 해결책이 아닙니다.
🎯 시험에서는 이렇게 풀면 됩니다
문제에:
HPL
not enough memory
가 같이 나오면 바로:
Problem Size
      ↓
N
을 떠올리세요.
그리고:
N ↓
→ Matrix ↓
→ Memory ↓
입니다.
시험 암기법 ⭐
HPL Memory 부족 → N 줄이기
그리고 구분해서 기억하세요.
| N | 전체 Problem/Matrix 크기 ⭐ |
| NB | Block Size / 성능 튜닝 |
| P, Q | MPI Process Grid |
| PMAP | Process Mapping |
| BCAST | Broadcast Algorithm |
한 줄 암기
N = 얼마나 큰 문제를 풀 것인가 → 메모리 사용량에 직접 영향
따라서 **Question #20 정답은 B ✅**입니다.
특히 N은 제곱으로 메모리 사용량에 영향을 주므로, N을 조금만 줄여도 메모리는 상당히 많이 줄어든다는 점까지 기억해두시면 HPL 관련 응용 문제도 쉽게 풀 수 있습니다.
===========================
NCP-AII 시험에서도 중요하고 실제 GPU 서버 운영에서도 꽤 중요한 개념입니다.
HPL이 뭐야?
HPL = High Performance LINPACK
쉽게 말하면:
CPU/GPU 클러스터에 아주 큰 행렬 계산을 시켜서 계산 성능과 안정성을 확인하는 벤치마크
입니다.
NVIDIA의 GPU 가속 HPL은 대규모 FP64(double precision) 행렬 연산을 수행해서 시스템의 계산 성능을 강하게 압박합니다. NVIDIA도 HPL을 FP64 처리 성능을 주로 스트레스 테스트하는 벤치마크로 설명합니다. NVIDIA Docs
예를 들어:
DGX / H200 Cluster

GPU0 ─┐
GPU1 ─┤
GPU2 ─┤
GPU3 ─┼── HPL 계산
GPU4 ─┤
GPU5 ─┤
GPU6 ─┤
GPU7 ─┘
을 장시간 돌리면서 다음을 확인할 수 있습니다.
- GPU 계산 성능
- GPU Utilization
- GPU 안정성
- 전력/발열 안정성
- GPU Memory
- CPU/NUMA 배치
- Multi-node 통신
- 클러스터 Burn-in
N은 뭔가요?
HPL은 내부적으로 매우 큰 행렬을 계산합니다.
N × N여기서 N이 행렬의 크기, 즉 Problem Size입니다.
예를 들어:
N = 100,000

100,000 × 100,000 행렬
을 계산하는 식입니다.
그리고 double precision 값 하나는 8 byte이므로 대략적인 행렬 메모리는:
Memory ≈ N × N × 8 byte입니다.
따라서:
N이 커질수록 HPL이 사용하는 메모리가 급격하게 증가합니다.
특히 N을 2배로 올리면 필요한 행렬 메모리는 대략 4배가 됩니다. Netlib HPL도 가능한 메모리 범위 안에서 가장 큰 N을 사용하되 OS 및 기타 용도를 위해 여유 메모리를 남겨야 한다고 안내합니다. Netlib
실제 운영에서는 N을 어떻게 줄이나?
중요한 부분입니다.
NVIDIA HPL에서는 보통 실행할 때:
./hpl.sh --dat ./HPL.dat처럼 HPL.dat 파일을 읽습니다.
NVIDIA 공식 HPL도 표준 Netlib HPL.dat 형식을 사용하며 --dat 옵션으로 파일 경로를 지정합니다. NVIDIA Docs
따라서 N을 줄이는 작업은 대부분 HPL.dat 수정입니다.
1. 먼저 현재 N 확인
grep -n "Ns" HPL.dat예를 들어:
5:1            # of problem sizes (N)
6:500000       Ns
라고 나오면:
N = 500000입니다.
표준 HPL.dat에서 Problem Size의 개수는 line 5, 실제 N 값들은 다음 line에 위치합니다. Netlib
2. 가장 쉬운 방법: vi로 변경
vi HPL.dat기존:
1            # of problem sizes (N)
500000       Ns
이라면:
1            # of problem sizes (N)
450000       Ns
처럼 줄입니다.
즉:
500000
   ↓
450000
으로 바꾸는 겁니다.
NB(Block Size)는 그대로 둡니다.
예:
1            # of NBs
1024         NBs
그대로 유지합니다.
Question #20에서 말한:
Reduce the problem size while maintaining the same block size.
가 바로 이것입니다.
3. 명령어 한 줄로 변경하려면
운영 서버에서 자동화하려면 먼저 백업합니다.
cp HPL.dat HPL.dat.bak그 다음 예를 들어 N을 500000 → 450000으로 변경한다면:
sed -i 's/^500000[[:space:]]*Ns/450000 Ns/' HPL.dat그리고 확인:
grep -n "Ns" HPL.dat결과:
450000 Ns이면 정상입니다.
다만 HPL.dat의 공백이나 형식이 환경마다 조금 다를 수 있기 때문에 운영에서는 먼저 grep으로 실제 줄을 확인하고 수정하는 게 안전합니다.
4. 다시 HPL 실행
예를 들어 DGX/H200 8-GPU 단일 노드라면:
srun -N 1 \
  --ntasks-per-node=8 \
  --cpu-bind=none \
  --mpi=pmix \
  ./hpl.sh \
  --dat ./HPL.dat
NVIDIA HPL은 GPU당 MPI process 1개를 기대하기 때문에 8 GPU 노드라면 일반적으로 8 MPI ranks를 사용합니다. NVIDIA Docs
앞에서 배운 affinity까지 넣는다면:
srun -N 1 \
  --ntasks-per-node=8 \
  --cpu-bind=none \
  --mpi=pmix \
  ./hpl.sh \
  --dat ./HPL.dat \
  --gpu-affinity 0:1:2:3:4:5:6:7 \
  --cpu-affinity 0-13:14-27:28-41:42-55:56-69:70-83:84-97:98-111 \
  --mem-affinity 0:0:0:0:1:1:1:1
이 CPU/Memory affinity는 DGX H100 공식 예시이므로 다른 H200 서버에서는 topology를 확인한 후 맞춰야 합니다. NVIDIA Docs
그런데 RAM이 충분한데 왜 not enough memory가 나올까?
여기가 중요합니다.
GPU HPL에서는 단순히:
서버 RAM 2TB니까 충분하다라고 판단하면 안 됩니다.
실제로는:
Host RAM
+
GPU Memory
+
CUDA Buffer
+
NCCL / MPI Buffer
+
HPL Workspace
+
Driver Reserved Memory
등이 모두 필요합니다.
특히 GPU HPL의 in-core mode에서는 GPU Memory가 중요한 제한 요소가 될 수 있습니다.
따라서:
서버 RAM 충분
        ≠
HPL Memory 충분
입니다.
NVIDIA HPL에는 OOC 모드도 있습니다
조금 더 실무적으로 보면 NVIDIA HPL에는:
OOC = Out-of-Core
모드도 있습니다.
export HPL_OOC_MODE=1을 사용하면 GPU Memory를 넘어가는 행렬 일부를 Host CPU Memory에 저장할 수 있습니다. NVIDIA 공식 문서도 OOC mode에서 GPU memory를 초과하는 matrix data를 CPU host memory에 저장한다고 설명합니다. NVIDIA Docs
예:
export HPL_OOC_MODE=1

srun -N 1 \
  --ntasks-per-node=8 \
  --cpu-bind=none \
  --mpi=pmix \
  ./hpl.sh --dat ./HPL.dat
다만 Question #20의 답은 OOC를 켜라는 문제가 아니라 N을 줄이는 문제입니다.
실제 장애 대응 순서
제가 운영한다면 이렇게 봅니다.
HPL
"not enough memory"
        ↓
1. HPL.dat의 N 확인
        ↓
2. GPU Memory 확인
   nvidia-smi
        ↓
3. 다른 GPU Process 확인
        ↓
4. N을 줄임
        ↓
5. HPL 재실행
        ↓
6. GPU Util / Memory 확인
명령으로 보면:
nvidia-smi↓
grep -n "Ns" HPL.dat↓
cp HPL.dat HPL.dat.bak↓
vi HPL.dat↓
500000 Ns
↓
450000 Ns
↓
srun ... ./hpl.sh --dat ./HPL.dat🎯 시험 + 실무 암기
HPL
= GPU/CPU 계산 성능·안정성 테스트

N
= 전체 행렬 크기

NB
= Block Size
그리고:
Memory 부족 → N ↓
입니다.
가장 중요한 한 줄
HPL OOM
   ↓
HPL.dat
   ↓
N 값 줄이기
   ↓
다시 ./hpl.sh --dat HPL.dat 실행
사용자님의 H200 × 8 / 노드 환경이라면 다음 단계로 제가 **“H200 141GB × 8 기준으로 HPL.dat의 N 값을 어느 정도로 잡아야 하는지”**까지 계산해서, 실제 HPL.dat 샘플 전체를 만들어드릴 수도 있습니다.


댓글