An administrator is configuring node categories in BCM for a DGX BasePOD cluster. They need to group all NVIDIA DGX H200 nodes under a dedicated category for GPU-accelerated workloads.
Which approach aligns with NVIDIA’s recommended BCM practices?
- A. Avoid categories and configure each DGX node individually via CLI.
- B. Create a new “dgx-h200” category, assign all DGX H200 nodes to it.
- C. Use the existing “dgxnodes” category without modification, as it is preconfigured for all DGX systems.
- D. Assign nodes to the “login” category to simplify Slurm integration.
관리자가 DGX BasePOD 클러스터의 BCM에서 노드 범주를 구성하고 있습니다. 모든 NVIDIA DGX H200 노드를 GPU 가속 워크로드 전용 범주로 그룹화해야 합니다.
NVIDIA에서 권장하는 BCM 모범 사례에 부합하는 접근 방식은 무엇일까요?
- A. 카테고리를 사용하지 말고 CLI를 통해 각 DGX 노드를 개별적으로 구성하십시오.
- B. "dgx-h200"이라는 새 카테고리를 생성하고 모든 DGX H200 노드를 해당 카테고리에 할당합니다.
- C. 기존의 "dgxnodes" 카테고리는 모든 DGX 시스템에 대해 사전 구성되어 있으므로 수정 없이 그대로 사용하십시오.
- D. Slurm 통합을 간소화하기 위해 노드를 "로그인" 범주에 할당합니다.
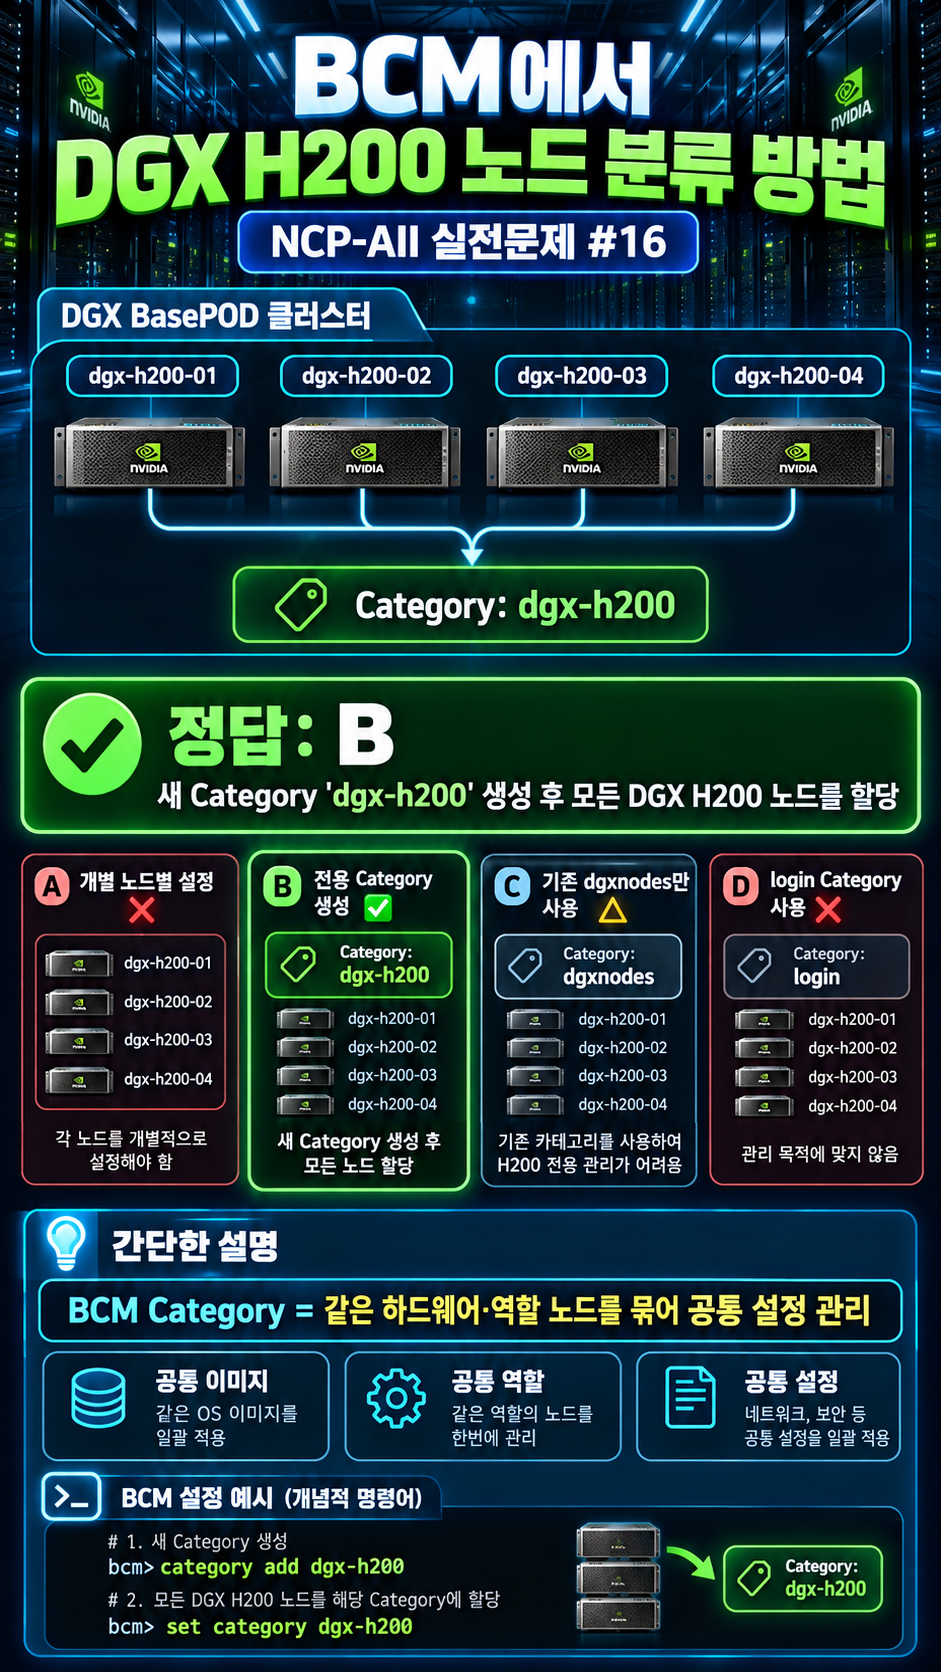
정답은 B. dgx-h200라는 새 Category를 만들고 모든 DGX H200 노드를 그 Category에 넣는 것입니다. ✅
NVIDIA BCM에서 Node Category는 같은 하드웨어 특성·역할·설정 요구사항을 가진 노드들을 묶어서 공통 설정을 상속시키는 단위입니다. DGX H200처럼 동일한 GPU 서버군은 별도 Category로 관리하는 방식이 BCM 철학과 가장 잘 맞습니다. NVIDIA Docs
쉽게 말하면
DGX H200 노드가 여러 대 있다고 해보겠습니다.
dgx-h200-01
dgx-h200-02
dgx-h200-03
dgx-h200-04
이걸 하나씩 따로 설정하는 대신:
Category: dgx-h200

 ├─ dgx-h200-01
 ├─ dgx-h200-02
 ├─ dgx-h200-03
 └─ dgx-h200-04
로 묶습니다.
그러면 Category에 설정한:
- Software Image
- Kernel Parameter
- Disk Layout
- Role
- Slurm 관련 설정
- 공통 네트워크/프로비저닝 설정
등을 여러 노드에 일괄 적용할 수 있습니다. BCM 공식 문서도 Category가 동일 특성의 노드를 그룹화하고 공통 설정을 상속시키는 용도라고 설명합니다. NVIDIA Docs
실제 DGX BasePOD에서도 이렇게 합니다
NVIDIA DGX BasePOD 가이드에서도 DGX 노드를 특정 Category에 할당하는 방식을 사용합니다.
예를 들어 DGX A100 환경에서는:
dgx01 → dgx-a100
dgx02 → dgx-a100
dgx03 → dgx-a100
dgx04 → dgx-a100
처럼 묶도록 안내합니다. NVIDIA Docs
즉 H200이라면 문제처럼:
dgx-h200같은 전용 Category를 만들어 H200 노드를 묶는 접근이 자연스럽습니다.
실제 BCM CLI 개념
예를 들어 cmsh에서 개념적으로:
category
add dgx-h200
commit
Category를 만든 뒤 DGX H200 노드에:
device
use dgx-h200-01
set category dgx-h200
commit
같은 식으로 할당할 수 있습니다.
노드가 많으면 일괄 처리하는 형태가 더 효율적입니다.
NVIDIA BasePOD 가이드에서도 이런 식으로 foreach를 사용합니다.
foreach -n dgx01..dgx04 (set category dgx-a100)
commit
``` :chatgpt-content-reference{index="3"}


---

## ❌ A. 각각 개별 설정

> Avoid categories and configure each DGX node individually

BCM을 사용하는 장점을 버리는 방식입니다.

100대가 있다고 하면:

```text
Node01 설정
Node02 설정
Node03 설정
...
Node100 설정
이렇게 하면 운영이 너무 복잡해집니다.
Category를 사용하면:
dgx-h200 Category 설정
        ↓
H200 노드 전체 적용
이 됩니다.
✅ B. dgx-h200 Category 생성
정답입니다.
같은 하드웨어
+
같은 역할
+
같은 Software Image
+
같은 GPU workload
       ↓
같은 Category
BCM에서 가장 이상적인 구조입니다.
❌ C. 기존 dgxnodes를 무조건 사용
문제에서 dgxnodes가 모든 DGX 시스템용으로 미리 완벽히 준비된 Category라고 보장하지 않습니다.
BCM의 핵심은 하드웨어/역할에 맞게 Category를 정의하는 것입니다.
NVIDIA 최신 문서에서도 예를 들어:
dgx-b200-k8s처럼 특정 DGX 모델과 역할에 맞는 Category를 따로 사용합니다. NVIDIA Docs
따라서 H200이면 dgx-h200 같은 별도 Category가 더 적절합니다.
❌ D. login Category에 넣기
login 노드는 사용자 접속 및 Job 제출용입니다.
GPU compute node와 역할이 다릅니다.
Login Node
→ 사용자 SSH 접속
→ Job 제출

DGX H200 Node
→ GPU 연산
→ AI Training
NVIDIA BasePOD Slurm 가이드에서도 GPU Compute Node Category와 Login/Submit Host를 구분해서 설정합니다. NVIDIA Docs
시험용 핵심
이 문제에서 바로 떠올릴 것은:
BCM Category = 같은 특성의 노드를 묶어서 공통 설정 관리
입니다.
DGX H200 여러 대
      ↓
동일 Hardware
      ↓
동일 AI Compute Role
      ↓
dgx-h200 Category
한 줄 암기
BCM에서 동일 DGX 모델은 전용 Category로 묶어서 공통 Image/Role/Config를 관리한다.
Question #16 정답: B ✅
그리고 이 문제에서 꼭 기억할 차이는:
Category = 설정을 상속받는 동일 구성 그룹
Node Group = 운영 편의를 위한 임의 묶음
입니다. 이 구분도 NCP-AII에서 꽤 잘 나오는 포인트입니다.


댓글