To validate bisectional bandwidth across two racks in a Spectrum-X Ethernet fabric, which NCCL test configuration isolates East-West traffic?
- A. Run without splits and analyze per-rack averages
- B. NCCL_TESTS_SPLIT= “MOD 2” ./all_reduce_perf -g 8
- C. NCCL_TESTS_SPLIT= “DIV 8” ./all_reduce_perf -g 1
- D. NCCL_TESTS_SPLIT= “OR 0x7” ./all_reduce_perf -g 8
Spectrum-X 이더넷 패브릭에서 두 랙 간의 양방향 대역폭을 검증하기 위해 어떤 NCCL 테스트 구성이 동서 트래픽을 분리합니까?
- A. 분할 없이 실행하고 랙별 평균을 분석합니다.
- B. NCCL_TESTS_SPLIT= “MOD 2” ./all_reduce_perf -g 8
- C. NCCL_TESTS_SPLIT= “DIV 8” ./all_reduce_perf -g 1
- D. NCCL_TESTS_SPLIT= “OR 0x7” ./all_reduce_perf -g 8
정답은 B. NCCL_TESTS_SPLIT="MOD 2" ./all_reduce_perf -g 8 입니다. ✅
이 문제는 앞에서 풀었던 NVLink/NVSwitch 단일 노드 bisection 문제와 비슷하지만, 이번에는 Spectrum-X Ethernet에서 Rack ↔ Rack, 즉 East-West 트래픽을 검증하는 문제입니다.
NVIDIA 공식 nccl-tests 문서에서 MOD 2는 전체 rank를 짝수/홀수 두 그룹으로 나누고, 각각의 그룹이 every-other-rank를 사용해 동시에 NCCL operation을 수행한다고 설명합니다. GitHub
1. 문제를 쉽게 번역하면
두 개의 Rack에 걸쳐 있는 Spectrum-X Ethernet 환경에서
Rack과 Rack 사이의 네트워크 대역폭을 검증하고 싶다.
어떤 NCCL 테스트 설정이 적절한가?
핵심 단어는:
Two racks
   +
Spectrum-X
   +
Bisectional Bandwidth
   +
East-West Traffic
입니다.
2. East-West Traffic이 뭐야?
초보자 기준으로 가장 쉽게 보면:
데이터센터 내부 서버 ↔ 서버 통신
입니다.
예를 들어:
Rack A                         Rack B

DGX01 ─┐                    ┌─ DGX05
DGX02 ─┼─ Leaf ─ Spine ─ Leaf ─ DGX06
DGX03 ─┤                    ├─ DGX07
DGX04 ─┘                    └─ DGX08
Rack A의 DGX가 Rack B의 DGX와 데이터를 주고받으면:
Rack A  ←────────────→ Rack B
            East-West
입니다.
NVIDIA도 Spectrum-X를 AI workload의 GPU-to-GPU / node-to-node East-West 통신에 최적화된 Ethernet fabric으로 설명합니다. NVIDIA Developer
3. 왜 MOD 2인가?
예를 들어 전체 NCCL rank가:
Rank 0
Rank 1
Rank 2
Rank 3
Rank 4
Rank 5
Rank 6
Rank 7
...
라고 해보겠습니다.
여기에:
NCCL_TESTS_SPLIT="MOD 2"를 적용합니다.
rank % 2를 계산합니다.
Rank 0 % 2 = 0
Rank 1 % 2 = 1
Rank 2 % 2 = 0
Rank 3 % 2 = 1
Rank 4 % 2 = 0
Rank 5 % 2 = 1
...
그러면:
Group 0
0, 2, 4, 6, 8, 10 ...

Group 1
1, 3, 5, 7, 9, 11 ...
두 그룹으로 나뉩니다.
공식 nccl-tests 문서에서도:
AND 0x1 또는 MOD 2
→ 두 개의 operation 생성
→ 각각 every-other-rank 사용
이라고 명시합니다. GitHub
4. Rack을 걸쳐 실행하면 어떻게 되나요?
예를 들어 rank들이 두 Rack의 여러 DGX에 배치되어 있다고 해보겠습니다.
Rack A                     Rack B

Rank 0                     Rank 8
Rank 1                     Rank 9
Rank 2                     Rank 10
Rank 3                     Rank 11
...                        ...
MOD 2를 사용하면 두 communicator 모두 여러 노드/Rack에 걸쳐 만들어질 수 있습니다.
Group 0
Rack A GPU ───────── Rack B GPU

Group 1
Rack A GPU ───────── Rack B GPU
그리고 두 그룹에서 동시에:
AllReduce를 실행합니다.
결과적으로:
Rack A
  │
  │ 대량의 NCCL Traffic
  ▼
Leaf
  │
Spine
  │
Leaf
  ▼
Rack B
처럼 East-West fabric에 실제 부하를 줄 수 있습니다.
POINT. MOD 2만 설정한다고 물리 Rack 위치가 자동으로 결정되는 것은 아닙니다. 실제 환경에서는 MPI/Slurm rank placement가 두 Rack에 걸쳐 있도록 배치해야 합니다.
5. all_reduce_perf는 왜 사용하나?
./all_reduce_perf -g 8all_reduce_perf는 여러 GPU가 서로 데이터를 주고받으며 AllReduce 성능을 측정합니다.
GPU 계산 결과
 ↓
AllReduce
 ↓
다른 Node로 전송
 ↓
Spectrum-X Ethernet
 ↓
다른 Rack
 ↓
다른 GPU
그래서 AI 분산학습에서 실제 사용하는 통신 패턴과 유사한 부하를 네트워크에 줄 수 있습니다.
NCCL Tests에서 특히 busbw는 NVLink, PCIe 또는 네트워크 같은 실제 통신 fabric의 성능을 비교하기 위한 지표입니다. GitHub
6. ❌ A — Split 없이 실행
Run without splits물론 일반적인 AllReduce 성능은 측정할 수 있습니다.
하지만:
전체 Traffic 혼합
 ↓
Intra-node
Intra-rack
Inter-rack
이 섞일 수 있습니다.
문제는 특별히:
isolates East-West traffic
이라고 했습니다.
따라서 split을 사용하는 B가 더 적절합니다.
7. ❌ C — DIV 8
NCCL_TESTS_SPLIT="DIV 8" ./all_reduce_perf -g 1여기가 중요한 함정입니다. ⚠️
NVIDIA 공식 nccl-tests 문서에서:
OR 0x7
또는
DIV 8
은 8-GPU 시스템에서 node별 operation, 즉 purely intra-node 테스트를 만드는 예로 제시됩니다. GitHub
예를 들어:
Rank 0~7
→ Group 0

Rank 8~15
→ Group 1
8 GPU/node라면:
Node 1 GPU 8개 → Group 0
Node 2 GPU 8개 → Group 1
가 되어 각각 자기 노드 안에서 통신합니다.
즉:
Node1 내부 ←→ Node1 내부

Node2 내부 ←→ Node2 내부
그래서 Rack 간 East-West 검증과 반대 방향입니다.
8. ❌ D — OR 0x7
NCCL_TESTS_SPLIT="OR 0x7"공식 문서상:
OR 0x7
≈ DIV 8
의 활용 예는 8-GPU/node 시스템에서:
one operation per node → purely intra-node
입니다. GitHub
따라서 이것 역시 Rack-to-Rack East-West bandwidth 테스트에는 맞지 않습니다.
🔥 이 문제에서 특히 주의할 점
웹의 일부 비공식 문제은행에서는 이 문제의 답을 DIV 8로 표시하는 곳이 있습니다.
하지만 NVIDIA 공식 nccl-tests 문서의 split 정의를 그대로 적용하면:
MOD 2
→ Every other rank
→ Multi-node communicator 가능
→ Inter-node / East-West 부하

DIV 8 / OR 0x7
→ 8-GPU node별 그룹
→ Intra-node
이므로 주어진 보기에서는 B가 기술적으로 가장 타당합니다. GitHub
🎯 시험용 암기
이건 표로 외우시면 좋습니다.
| MOD 2 / AND 0x1 | 짝수/홀수 rank → 2개의 교차 그룹 |
| MOD 8 / AND 0x7 | GPU별 그룹 → inter-node 통신에 활용 가능 |
| DIV 8 / OR 0x7 | Node별 그룹 → intra-node |
한 줄 암기
두 Rack 사이 East-West Bisection → MOD 2로 rank를 교차 분할 → AllReduce
따라서 Question #17 = B ✅
그리고 이번 문제는 앞의 Question #4와 연결해서 기억하면 좋습니다.
Q4 단일 DGX NVSwitch
→ AND 0x1
→ Even/Odd GPU

Q17 두 Rack Spectrum-X
→ MOD 2
→ Even/Odd Rank
→ East-West Network
AND 0x1과 MOD 2는 공식 nccl-tests에서 동일한 2-group 분할 효과를 냅니다. GitHub
============================
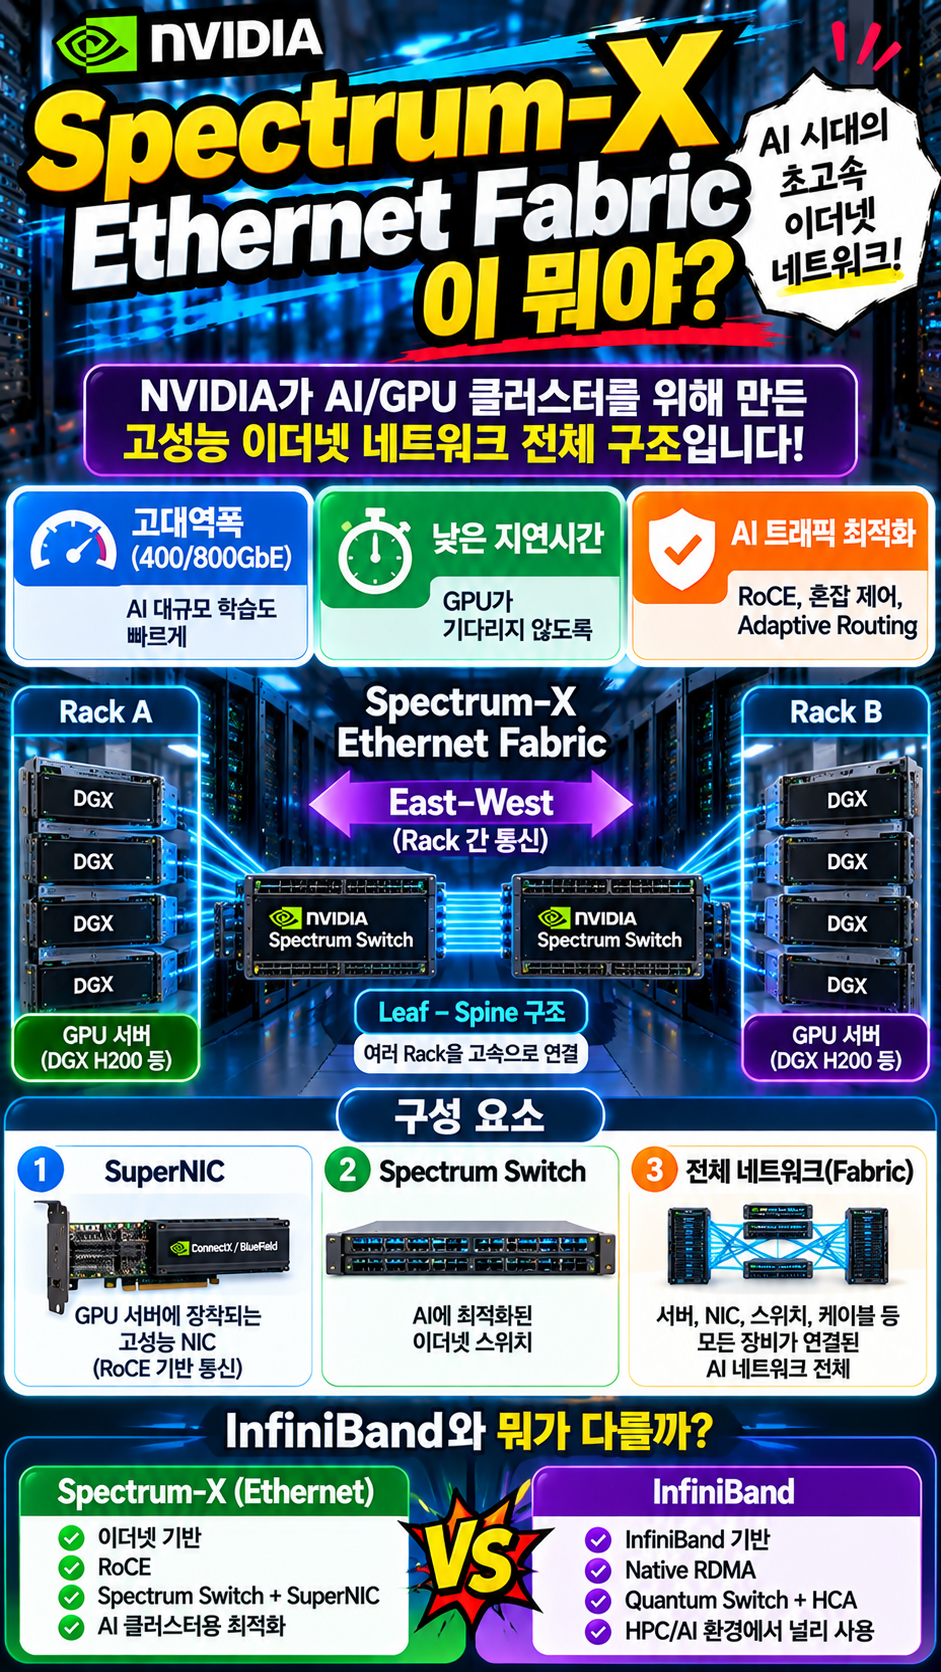
Spectrum-X Ethernet Fabric은 NVIDIA가 AI/GPU 클러스터용으로 최적화한 고속 이더넷 네트워크 전체입니다.
즉,
Spectrum-X = AI용 초고속 Ethernet 기술
Fabric = 서버·NIC·스위치·케이블이 연결된 전체 네트워크 구조
라고 보면 됩니다. NVIDIA는 Spectrum-X를 Spectrum Ethernet Switch + SuperNIC을 결합한 AI 최적화 Ethernet 플랫폼으로 설명합니다. NVIDIA
1. 일반 Ethernet하고 뭐가 다른가?
일반 Ethernet도 서버끼리 통신할 수 있습니다.
Server A
   │
Ethernet Switch
   │
Server B
하지만 AI 클러스터에서는 수백~수천 개 GPU가 동시에 엄청난 데이터를 주고받습니다.
GPU Server 1 ─┐
GPU Server 2 ─┤
GPU Server 3 ─┼─ Switch ─ 다른 Rack
GPU Server 4 ─┘
이때 일반 Ethernet은 혼잡, 지연, 패킷 손실 때문에 GPU가 기다리는 상황이 생길 수 있습니다.
Spectrum-X는 이런 AI 트래픽을 위해:
- 높은 대역폭
- 낮은 latency
- RoCE
- Adaptive Routing
- Congestion Control
- Performance Isolation
등을 최적화한 Ethernet입니다. NVIDIA는 Spectrum-X가 AI용으로 고대역폭 lossless RoCE 기반 East-West 네트워크를 제공한다고 설명합니다. NVIDIA Docs
2. Spectrum-X 안에는 뭐가 있나?
초보자 기준으로 핵심은 두 가지입니다.
GPU Server
   │
SuperNIC
   │
Spectrum-X Ethernet Switch
   │
다른 GPU Server
SuperNIC
GPU 서버 쪽에 장착되는 고성능 NIC입니다.
예:
- BlueField-3 SuperNIC
- ConnectX-8
- ConnectX-9
이 장치가 GPU 서버의 고속 통신을 담당합니다. NVIDIA는 SuperNIC이 GPU 서버 간 RoCE 기반 고대역폭 연결을 제공한다고 설명합니다. NVIDIA
Spectrum Switch
GPU 서버 여러 대를 연결하는 AI용 Ethernet Switch입니다.
DGX01 ─┐
DGX02 ─┤
DGX03 ─┼─ Spectrum Switch
DGX04 ─┘
3. Fabric은 왜 붙이나?
Spectrum-X Ethernet은 기술/플랫폼 이름이고,
Spectrum-X Ethernet Fabric은 실제 데이터센터에 구축된 전체 네트워크를 뜻합니다.
예를 들어:
Rack A                         Rack B

DGX01 ─┐                    ┌─ DGX05
DGX02 ─┼─ Leaf ─ Spine ─ Leaf ─ DGX06
DGX03 ─┤                    ├─ DGX07
DGX04 ─┘                    └─ DGX08
여기서:
SuperNIC
+ Cable
+ Leaf Switch
+ Spine Switch
+ 전체 연결 경로
를 모두 합쳐 Spectrum-X Ethernet Fabric이라고 부릅니다.
Fabric = 네트워크 장비 하나가 아니라 전체 연결망
입니다.
4. 앞 문제의 East-West와 연결하면
Question #17에서는:
두 Rack 사이 Spectrum-X Ethernet fabric의 East-West bandwidth를 확인
한다고 했죠.
East-West는:
Rack A  ←────────→  Rack B
      GPU 서버끼리 통신
입니다.
예를 들어 분산학습 중 NCCL AllReduce가 실행되면:
GPU
 ↓
NCCL
 ↓
SuperNIC
 ↓
Spectrum-X Switch
 ↓
다른 Rack
 ↓
SuperNIC
 ↓
GPU
이 경로를 타고 데이터가 이동합니다.
그래서 Spectrum-X는 GPU-to-GPU / node-to-node 통신용 AI compute fabric에 특히 중요합니다. NVIDIA Docs
5. InfiniBand와 차이는?
이 부분이 시험에서 중요합니다.
| 기반 | Ethernet | InfiniBand |
| AI 최적화 | O | O |
| RDMA | RoCE | Native RDMA |
| 장비 | Spectrum Switch + SuperNIC | Quantum Switch + HCA |
| 주요 용도 | AI Cloud / Ethernet AI Fabric | AI / HPC |
| NCCL 사용 | 가능 | 가능 |
즉:
Spectrum-X = Ethernet 기반 AI 네트워크
InfiniBand = InfiniBand 기반 AI/HPC 네트워크
입니다.
둘 다 목표는 비슷합니다.
GPU ↔ GPU
빠르게 통신
하지만 사용하는 네트워크 기술이 다릅니다.
시험용 암기
딱 이렇게 기억하세요.
Spectrum-X = NVIDIA의 AI 최적화 Ethernet
그리고:
Spectrum-X Fabric = Spectrum Switch + SuperNIC + Cable + Leaf/Spine으로 구성된 전체 AI 네트워크
앞 문제와 연결하면:
NCCL
 ↓
Spectrum-X
 ↓
RoCE
 ↓
Rack ↔ Rack
 ↓
East-West Traffic
입니다.
이 개념을 잡으면 앞으로 RoCE, SuperNIC, Spectrum Switch, Leaf-Spine, East-West 문제도 훨씬 쉽게 이해됩니다.


댓글