A network engineer is tasked with configuring the management, storage, and compute networks for a new DGX BasePOD deployment.
Which statement best describes the network segmentation required for optimal operation?
- A. A single VLAN for all types of network traffic.
- B. Two networks: one for management and one for compute.
- C. Four networks: compute, storage, out-of-band, and management.
네트워크 엔지니어는 새로운 DGX BasePOD 구축을 위한 관리, 스토리지 및 컴퓨팅 네트워크를 구성하는 임무를 맡았습니다.
최적의 작동을 위해 필요한 네트워크 세분화에 대한 설명은 무엇일까요?
- A. 모든 유형의 네트워크 트래픽을 위한 단일 VLAN.
- B. 두 개의 네트워크: 하나는 관리용이고 다른 하나는 연산용입니다.
- C. 네 가지 네트워크: 컴퓨팅, 스토리지, 대역 외, 관리.
정답은 C. Four networks: compute, storage, out-of-band, and management 입니다. ✅
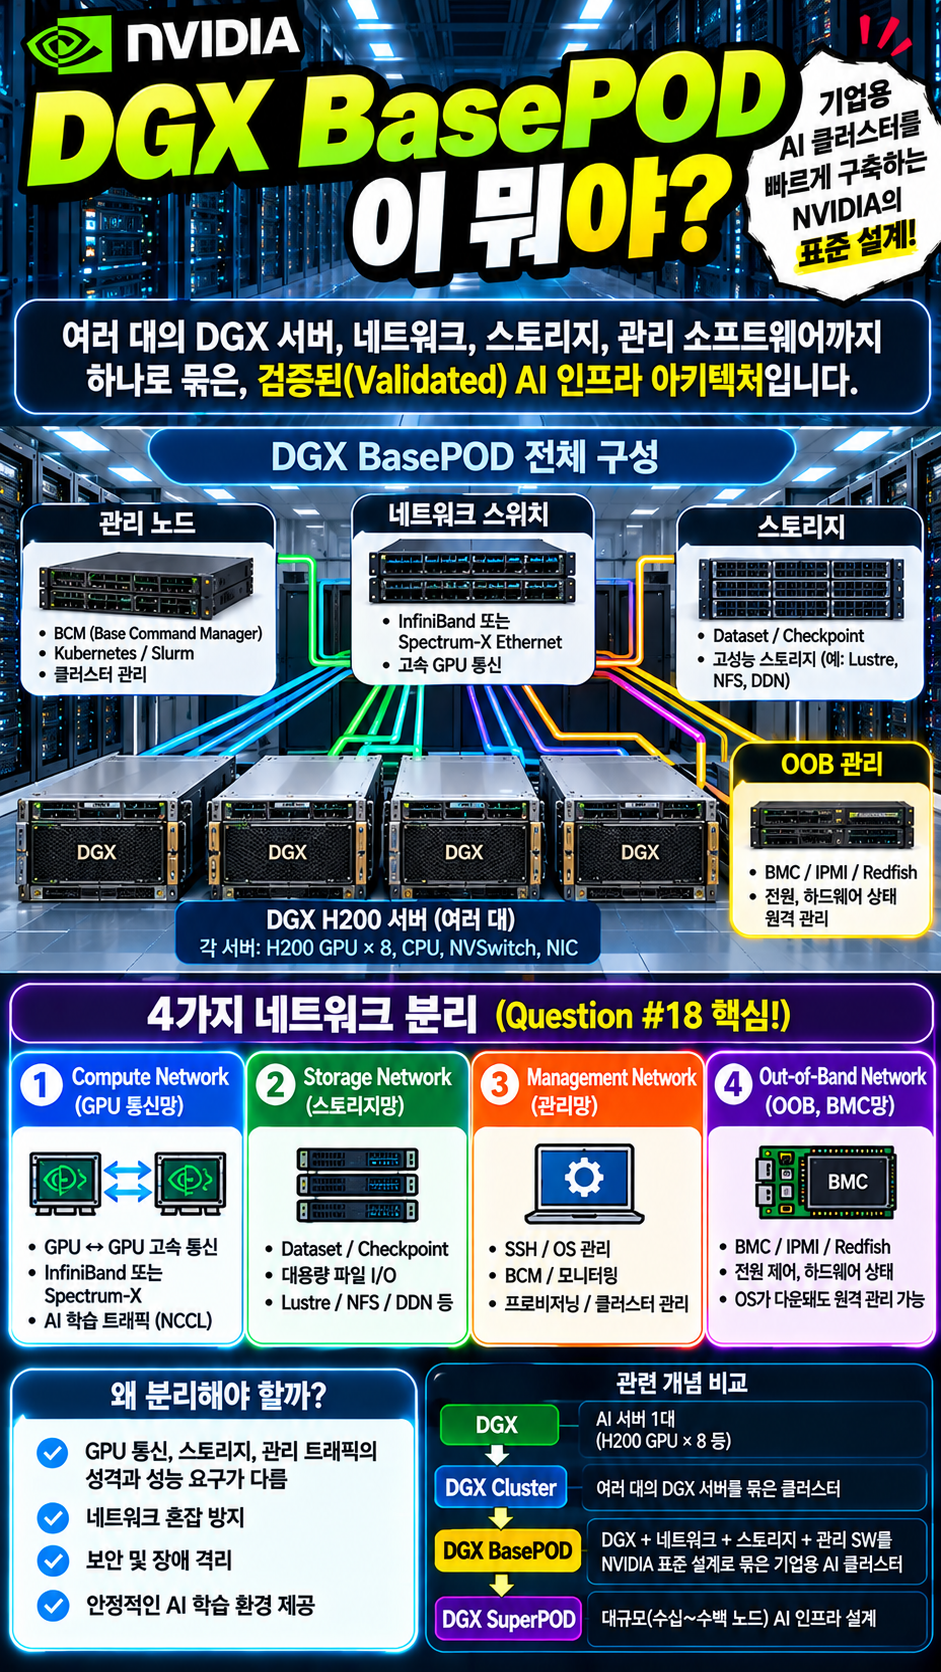
NVIDIA DGX BasePOD는 GPU 연산, 스토리지, 일반 관리, BMC 같은 트래픽의 성격과 성능 요구가 서로 다르기 때문에 역할별 네트워크를 분리하는 구조를 사용합니다. 최신 DGX H100/H200 BasePOD 문서에서도 Compute Fabric, Storage/In-band Management Fabric, Storage Fabric, Out-of-Band(BMC) Management를 구분해 설계합니다. NVIDIA Docs
1. 초보자 기준으로 보면
DGX H200 서버 한 대에 네트워크 선 하나만 연결해서 모든 것을 처리하는 구조가 아닙니다.
개념적으로는:
                  DGX H200
                     │
       ┌─────────────┼─────────────┐
       │             │             │
   Compute        Storage      Management
    Network        Network       Network
       │                             │
       │                          + OOB
       │                            BMC
시험에서는 다음 4가지 역할로 기억하면 됩니다.
| Compute | GPU ↔ GPU 고속 통신 |
| Storage | Dataset / Checkpoint / 파일 I/O |
| Management | SSH, OS 관리, 프로비저닝 등 |
| Out-of-Band | BMC/IPMI를 통한 하드웨어 관리 |
2. Compute Network ⭐
가장 중요한 AI 학습망입니다.
여러 DGX 서버의 GPU가 서로 통신할 때 사용합니다.
DGX01 GPU
     │
     │ NCCL
     ▼
Compute Fabric
     │
     ▼
DGX02 GPU
여기에 앞에서 공부한:
- InfiniBand
- 또는 Spectrum-X Ethernet
- NCCL
- RDMA / RoCE
가 연결됩니다.
예를 들어 InfiniBand를 사용하면:
DGX H200
   │
   HCA
   │
Quantum Switch
   │
   HCA
   │
DGX H200
입니다.
Compute Network = GPU 학습 데이터를 빠르게 주고받는 망
3. Storage Network
AI에서는 Dataset이나 Checkpoint 파일도 엄청나게 큽니다.
예를 들어:
DGX H200
   │
Storage Network
   │
Lustre / NFS / DDN
여기로:
Dataset 읽기
Checkpoint 저장
Model 파일 읽기
결과 파일 저장
등이 이동합니다.
만약 GPU 통신과 Storage Traffic을 같은 망에서 경쟁시키면:
NCCL Traffic ─┐
              ├─ 같은 Network → 혼잡
Storage I/O ──┘
GPU가 데이터를 기다릴 수 있습니다.
따라서 Storage Traffic을 분리하는 것이 중요합니다.
4. Management Network
관리자가 서버를 관리할 때 사용하는 네트워크입니다.
예를 들면:
SSH
OS Update
Monitoring
Provisioning
Slurm 관리
BCM 관리
등입니다.
구조로 보면:
관리자 PC
   ↓
Management Network
   ↓
DGX OS
입니다.
NVIDIA BasePOD 문서에서는 스토리지와 in-band management가 동일 Ethernet fabric을 공유하는 설계도 사용합니다. 따라서 실제 물리망/VLAN 설계에서는 이 둘이 하나의 Ethernet fabric에 있을 수도 있습니다. NVIDIA Docs
5. Out-of-Band Network가 특히 중요합니다
이건 BMC 전용 관리망이라고 이해하면 가장 쉽습니다.
관리자
  ↓
OOB Network
  ↓
BMC
  ↓
DGX Hardware
여기서:
- 전원 ON/OFF
- PSU 상태
- Temperature
- Firmware
- Remote Console
- IPMI / Redfish
등을 관리합니다.
DGX OS가 죽어도 BMC는 별도로 살아있을 수 있습니다.
예:
DGX OS ❌ 부팅 불가

그런데

BMC ✅ 접근 가능
그래서 원격에서:
전원 Reset
Console 확인
Hardware 상태 확인
등을 할 수 있습니다.
NVIDIA DGX 문서도 BMC Web/Remote Console/IPMI를 Out-of-Band Management 영역으로 별도로 분류합니다. NVIDIA Docs
🔥 In-Band와 Out-of-Band 차이
시험에서 자주 헷갈립니다.
In-Band Management
정상적인 OS 네트워크를 통해 관리합니다.
관리자
 ↓
Management Ethernet
 ↓
Linux / DGX OS
 ↓
SSH
OS가 죽으면 접근하기 어려울 수 있습니다.
Out-of-Band Management
OS와 별개입니다.
관리자
 ↓
OOB Network
 ↓
BMC
 ↓
Hardware
그래서 서버가 다운돼도 관리할 수 있습니다.
In-band = OS를 통해 관리
Out-of-band = BMC를 통해 하드웨어 직접 관리
❌ A. VLAN 하나로 전부 처리
Compute
Storage
Management
BMC
   ↓
Single VLAN
AI 클러스터에서는 좋지 않은 설계입니다.
GPU 통신과 Storage I/O, 관리 트래픽이 모두 경쟁하게 되고 보안/장애 격리도 어려워집니다.
❌ B. Management + Compute 두 개만 사용
Storage와 OOB가 빠져 있습니다.
특히 BMC는 보안과 장애 대응 때문에 일반 Management와 분리된 OOB 관리망을 두는 것이 중요합니다.
✅ C. 네 가지 역할 분리
DGX BasePOD

① Compute
   → GPU ↔ GPU

② Storage
   → Dataset / Checkpoint

③ Management
   → SSH / OS / BCM

④ Out-of-Band
   → BMC / IPMI / Redfish
따라서 C가 정답입니다.
🎯 시험 암기법
그냥 C-S-M-O로 기억해도 됩니다.
C = Compute
S = Storage
M = Management
O = Out-of-Band
또는:
GPU / DATA / OS / BMC
로 외우면 더 쉽습니다.
Compute     → GPU
Storage     → DATA
Management  → OS
Out-of-band → BMC
한 줄 암기
DGX BasePOD 네트워크 = Compute + Storage + Management + OOB(BMC)
Question #18 정답: C ✅
참고로 실제 NVIDIA BasePOD 구축에서는 “논리적 역할 4개”와 “물리적으로 반드시 스위치 4세트”는 같은 뜻이 아닙니다. 예를 들어 Storage와 In-band Management가 동일 Ethernet fabric을 공유하면서 VLAN 등으로 분리될 수도 있습니다. 시험에서는 우선 트래픽 역할 분리 개념을 잡는 것이 중요합니다.
================
쉽게 말하면 NVIDIA DGX BasePOD는 여러 대의 DGX 서버를 네트워크·스토리지·관리 소프트웨어까지 묶어서, 하나의 표준화된 AI 클러스터로 만든 구성입니다.
NVIDIA는 BasePOD를 기업용 AI 인프라를 빠르게 구축하기 위한 검증된(prescriptive) 아키텍처로 설명합니다. DGX H100/H200 같은 서버만 덜렁 여러 대 놓는 것이 아니라, 네트워크·스토리지·관리 노드·클러스터 관리 소프트웨어까지 함께 설계된 구조입니다. NVIDIA Docs
아주 쉽게 보면
DGX 한 대는:
DGX H200
 ├─ H200 GPU × 8
 ├─ CPU
 ├─ NVSwitch
 └─ NIC
입니다.
그런데 실제 기업 AI 환경에서는 DGX 한 대만으로 끝나지 않습니다.
DGX01
DGX02
DGX03
DGX04
...
이 서버들을 연결하고 관리해야 합니다.
그래서 NVIDIA가:
DGX 서버
+
고속 네트워크
+
스토리지
+
관리 서버
+
BCM
+
Kubernetes / Slurm
를 어떻게 구성할지 표준 설계로 만들어 놓은 것이 DGX BasePOD입니다.
BasePOD 구조
대표적으로 H100/H200 BasePOD는 이런 구조입니다.
               DGX BasePOD

        ┌─────────────────────┐
        │   Control / BCM     │
        │   Management Nodes  │
        └──────────┬──────────┘
                   │
        ┌──────────┴──────────┐

DGX H200      DGX H200      DGX H200
  GPU×8         GPU×8         GPU×8
    │             │             │
    └─────────────┼─────────────┘
                  │
           Compute Fabric
       InfiniBand / Ethernet
                  │
              Storage
실제 NVIDIA H100/H200 BasePOD 예시에는 DGX compute nodes, control-plane servers, compute fabric, management fabric, storage fabric, out-of-band management fabric가 포함됩니다. NVIDIA Docs
그래서 앞 문제의 네트워크 4개가 나온 겁니다
BasePOD는 단순히 DGX 서버만 모아 놓은 게 아닙니다.
DGX BasePOD

① Compute Network
   → GPU ↔ GPU

② Storage Network
   → Dataset / Checkpoint

③ Management Network
   → OS / BCM / SSH

④ Out-of-Band Network
   → BMC / IPMI
이런 식으로 역할을 분리합니다.
즉 Question #18에서:
Four networks: compute, storage, out-of-band, and management
가 나온 이유가 바로 BasePOD가 데이터센터 전체 AI 인프라 설계이기 때문입니다.
BCM도 BasePOD의 핵심입니다
앞에서 공부한 **BCM(Base Command Manager)**도 여기 들어갑니다.
BCM은 BasePOD에서:
- DGX OS 설치
- 노드 프로비저닝
- Kubernetes 배포
- 클러스터 상태 모니터링
- 노드 관리
등을 담당합니다. NVIDIA H100/H200 BasePOD 문서에서도 BCM을 핵심 소프트웨어 구성요소로 설명합니다. NVIDIA Docs
그래서 앞 문제의:
Category: dgx-h200도 결국 BasePOD 안에서 여러 DGX 노드를 효율적으로 관리하기 위한 기능입니다.
BasePOD와 DGX Cluster는 뭐가 달라?
이 차이를 알아두면 좋습니다.
DGX Cluster
그냥 넓은 의미입니다.
DGX 서버 여러 대를 묶은 클러스터
DGX + DGX + DGX + DGXDGX BasePOD
좀 더 구체적입니다.
NVIDIA가 검증한 표준 구조대로 만든 DGX AI 클러스터
DGX Servers
+
Network
+
Storage
+
Management
+
BCM
+
Validated Architecture
즉:
모든 BasePOD는 DGX Cluster지만, 모든 DGX Cluster가 BasePOD인 것은 아닙니다.
SuperPOD하고는 뭐가 달라?
이것도 NCP-AII에서 알아두면 좋습니다.
아주 단순화하면:
DGX 1대
   ↓
DGX Cluster
   ↓
DGX BasePOD
   ↓
DGX SuperPOD
라고 규모와 표준화 수준을 생각하면 쉽습니다.
BasePOD는 NVIDIA 공식 최신 Reference Architecture에서 2노드부터 수십 노드 규모까지 확장 가능한 기업 AI 인프라로 설명됩니다. NVIDIA Docs
SuperPOD는 그보다 훨씬 큰 대규모 AI 인프라 설계에 사용됩니다.
시험용 한 줄 암기
DGX = AI 서버 1대
DGX Cluster = DGX 여러 대
DGX BasePOD = DGX + Network + Storage + BCM을 NVIDIA 표준 설계로 묶은 기업용 AI 클러스터
그리고 Question #18과 연결해서:
DGX BasePOD
   ↓
Compute
Storage
Management
OOB(BMC)
이렇게 기억하면 됩니다.


댓글