Why is it important to provide a large and high-performance local cache (using SSDs configured as RAID-0) for deep learning workloads on DGX systems?
- A. Using local SSD cache in RAID-0 enables direct GPU access to files without host CPU involvement, further boosting performance.
- B. Local SSD cache allows users to increase the number of NFS threads on the server without impacting storage reliability.
- C. A local SSD cache in RAID-0 ensures that most training data is read only once from the network, significantly reducing NFS traffic.
- D. Local SSD cache in RAID-0 is necessary to provide redundancy in case one of the drives fails during long training runs.
DGX 시스템에서 딥러닝 워크로드에 대용량 고성능 로컬 캐시(RAID-0으로 구성된 SSD 사용)를 제공하는 것이 중요한 이유는 무엇입니까?
- A. RAID-0에서 로컬 SSD 캐시를 사용하면 호스트 CPU 개입 없이 GPU가 파일에 직접 액세스할 수 있으므로 성능이 더욱 향상됩니다.
- B. 로컬 SSD 캐시를 사용하면 스토리지 안정성에 영향을 주지 않고 서버에서 NFS 스레드 수를 늘릴 수 있습니다.
- C. RAID-0으로 구성된 로컬 SSD 캐시는 대부분의 학습 데이터가 네트워크에서 한 번만 읽히도록 보장하여 NFS 트래픽을 크게 줄입니다.
- D. RAID-0에서 로컬 SSD 캐시는 장시간 학습 실행 중 드라이브 중 하나에 오류가 발생할 경우를 대비하여 이중화를 제공하는 데 필요합니다.
정답은 C. Local SSD cache in RAID-0 ensures that most training data is read only once from the network, significantly reducing NFS traffic 입니다. ✅
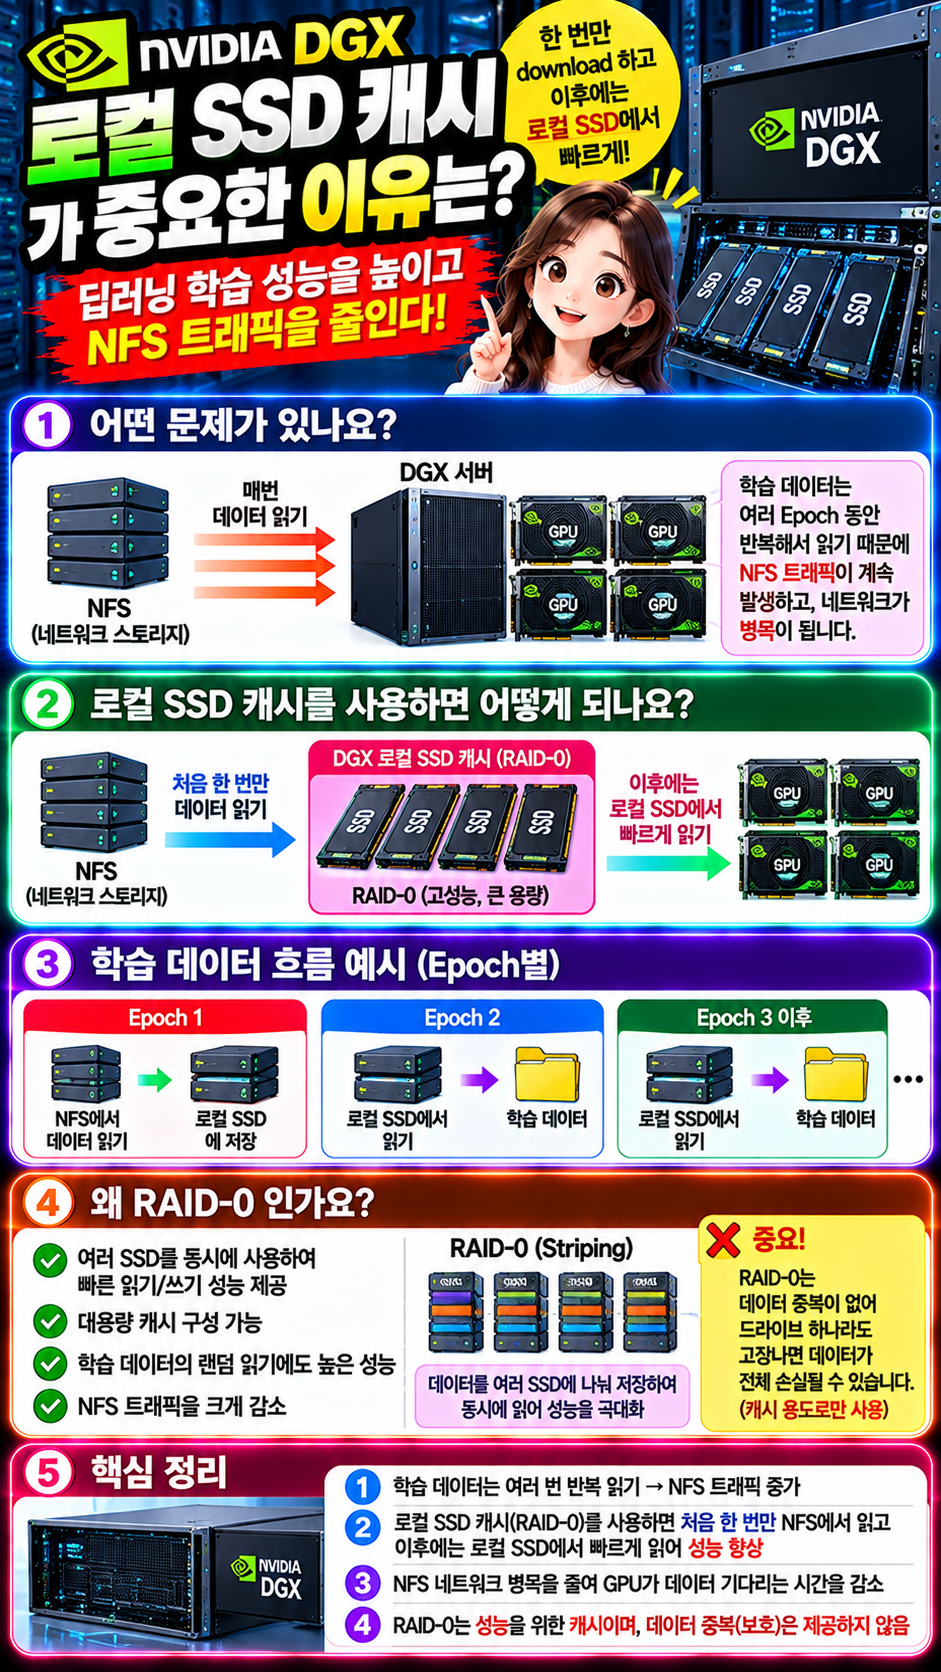
이 문제의 핵심은 딥러닝 학습 데이터는 같은 데이터를 여러 epoch 동안 반복해서 읽기 때문에, 첫 번째 읽기만 NFS에서 가져오고 이후에는 로컬 SSD 캐시에서 읽게 만들면 네트워크 스토리지 부하를 크게 줄일 수 있다는 점입니다. NVIDIA DGX Best Practices도 충분한 local cache가 있으면 이후 pass에서는 NFS에서 데이터를 다시 읽지 않아도 된다고 설명합니다. NVIDIA Docs
쉽게 이해하면
예를 들어 학습 데이터가 NFS에 있다고 하겠습니다.
Epoch 1
NFS → DGX
      ↓
Local SSD Cache 저장
그다음 epoch부터는:
Epoch 2
Local SSD → GPU

Epoch 3
Local SSD → GPU

Epoch 4
Local SSD → GPU
...
이렇게 됩니다.
즉:
네트워크에서 매번 데이터를 읽지 않고, 처음 한 번만 가져온 뒤 로컬 SSD에서 반복 사용
하는 겁니다.
왜 RAID-0인가?
RAID-0는 여러 SSD에 데이터를 Striping해서 나눠 저장합니다.
예를 들어 SSD가 4개라면:
File A

SSD1 → 일부
SSD2 → 일부
SSD3 → 일부
SSD4 → 일부
여러 디스크를 동시에 사용하므로:
용량과 성능을 최대한 끌어올릴 수 있습니다.
NVIDIA DGX 문서도 local data drives의 RAID-0를 성능 중심 NFS cache 용도로 사용한다고 설명합니다. NVIDIA Docs
중요한 점: RAID-0는 안전한 저장소가 아닙니다
이건 시험에서 아주 중요합니다.
RAID-0:
성능 ✅
용량 ✅
Redundancy ❌
SSD 하나만 고장나도 RAID-0의 데이터 전체를 잃을 수 있습니다. 그래서 NVIDIA도 /raid를 캐시 용도로 사용하고, 중요한 영구 데이터는 NFS 같은 외부 스토리지에 저장하라고 권장합니다. NVIDIA Docs
즉 구조는:
NFS / Parallel Storage
     ↓
원본 Dataset 보관
     ↓
DGX Local RAID-0 SSD
     ↓
Temporary Cache
     ↓
GPU Training
입니다.
✅ C가 정답인 이유
C:
A local SSD cache in RAID-0 ensures that most training data is read only once from the network, significantly reducing NFS traffic.
정확합니다.
딥러닝 학습은 보통 같은 Dataset을 여러 번 반복해서 읽습니다.
예:
Dataset
 ↓
Epoch 1
Epoch 2
Epoch 3
...
Epoch 100
캐시가 없다면:
Epoch 1 → NFS
Epoch 2 → NFS
Epoch 3 → NFS
...
하지만 캐시가 있으면:
Epoch 1 → NFS → Local Cache

Epoch 2 → Local Cache
Epoch 3 → Local Cache
...
가 됩니다.
그래서:
- NFS Traffic 감소
- Network bottleneck 감소
- Random I/O 성능 향상
- GPU가 데이터 기다리는 시간 감소
효과가 생깁니다. NVIDIA도 DGX의 SSD cache는 높은 random IOPS 성능을 이용해 randomized training data access에 대응한다고 설명합니다. NVIDIA Docs
❌ A. GPU가 CPU 없이 직접 접근한다
이건 이 문제의 핵심이 아닙니다.
local SSD cache = GPUDirect Storage
가 아닙니다.
RAID-0 local cache의 주 목적은:
NFS 반복 읽기 감소입니다.
GPU direct access를 자동으로 보장하는 기능이 아닙니다.
❌ B. NFS thread 증가
Local cache를 만든다고 NFS thread 수를 늘리는 것이 핵심은 아닙니다.
오히려 목적은:
NFS에 가는 요청 자체를 줄이는 것
입니다.
❌ D. RAID-0가 redundancy 제공
반대입니다.
RAID-0
→ Redundancy 없음
SSD 하나가 고장나면 배열 데이터 전체가 손실될 수 있습니다. NVIDIA Docs
따라서 D는 명확히 오답입니다.
🎯 시험용 암기
이 문제는 이렇게 외우세요.
DGX Local SSD RAID-0 = 빠른 Cache
그리고:
첫 Dataset Read
→ NFS

이후 Epoch
→ Local SSD Cache
한 줄 암기
DGX RAID-0 local cache → NFS에서 데이터 한 번 읽고 이후 로컬 SSD에서 반복 사용 → NFS Traffic 감소
Question #28 정답: C ✅
특히 RAID-0 = 성능/캐시, RAID-5 = 상대적으로 데이터 보호로 구분해서 기억하면 관련 문제를 쉽게 풀 수 있습니다.


댓글