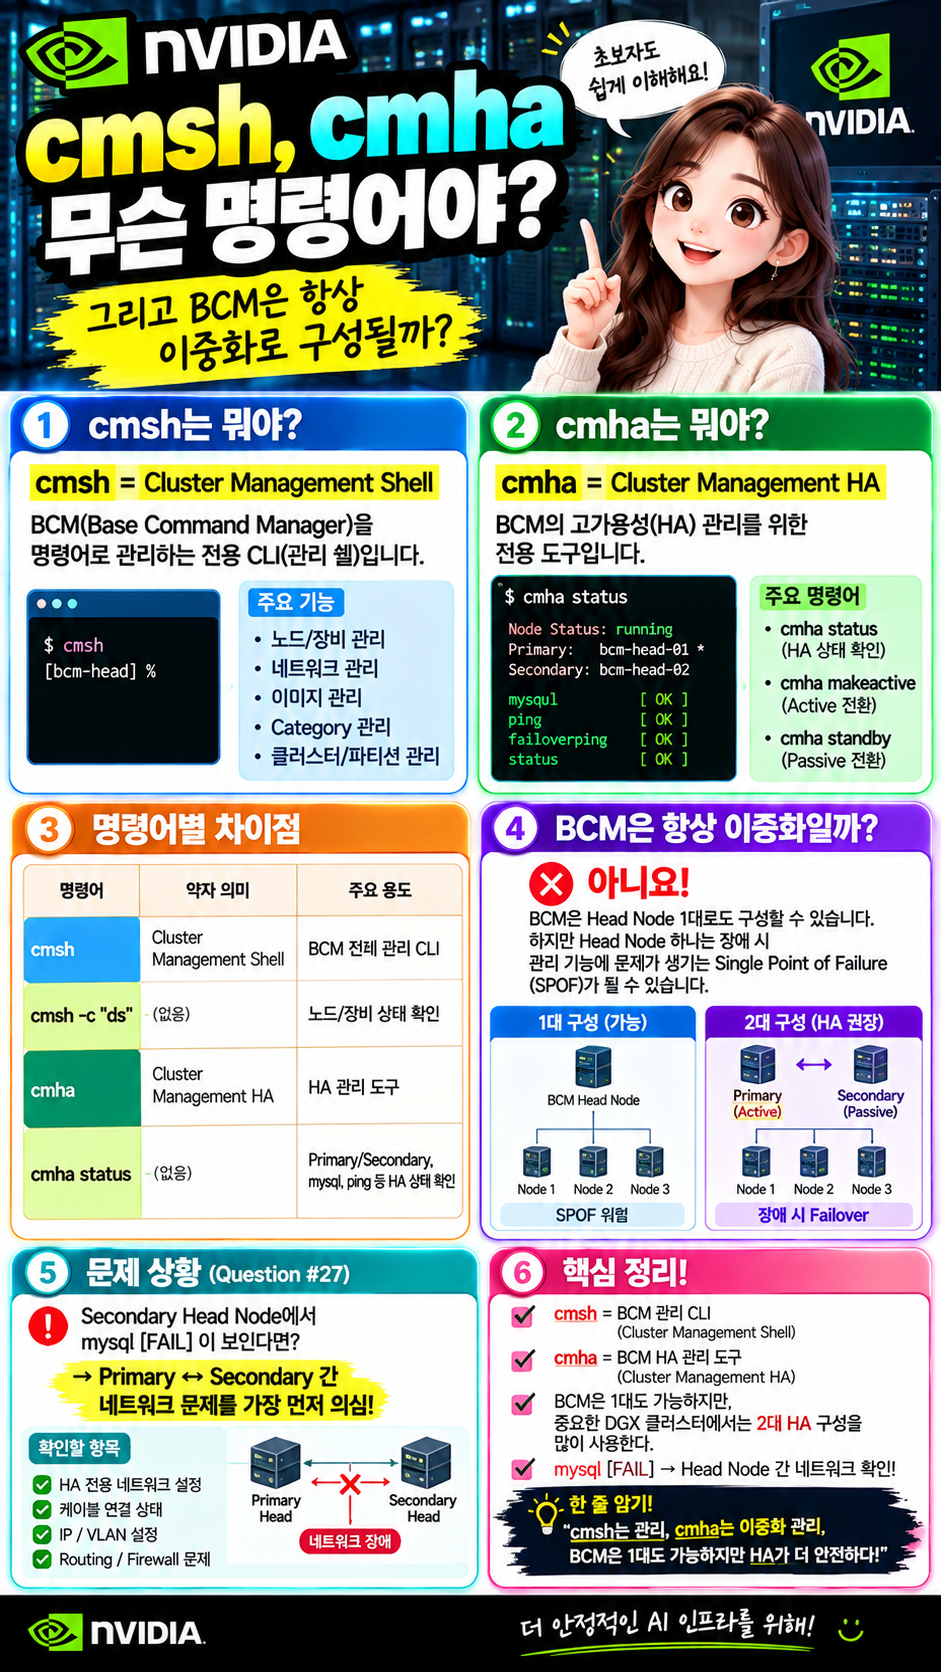
After configuring HA, the administrator runs cmsh status and notices the secondary head node reports mysql [FAIL].
What is the most likely cause?
- A. The secondary head node lacks NVIDIA GPU drivers.
- B. The BCM license expired after HA configuration.
- C. The cluster nodes are powered on during the HA configuration.
- D. Network connectivity issues between the primary and secondary head nodes.
고가용성(HA) 구성을 완료한 후, 관리자가 `cmsh status` 명령어를 실행하여 보조 헤드 노드에서 `mysql [FAIL]` 오류가 발생하는 것을 확인했습니다.
가장 가능성이 높은 원인은 무엇일까요?
- A. 보조 헤드 노드에 NVIDIA GPU 드라이버가 없습니다.
- B. HA 구성 후 BCM 라이선스가 만료되었습니다.
- C. HA 구성 중에 클러스터 노드의 전원이 켜집니다.
- D. 기본 헤드 노드와 보조 헤드 노드 간의 네트워크 연결 문제.
정답은 D. Network connectivity issues between the primary and secondary head nodes 입니다. ✅
NVIDIA BCM 공식 문서에서도 HA 환경에서 cmha status 결과의 mysql, ping, failoverping, status 중 하나라도 OK가 아니면 두 Head Node 사이의 네트워크 설정과 케이블링을 먼저 확인하라고 안내합니다. NVIDIA Docs
쉽게 보면
BCM HA는 보통 이렇게 구성됩니다.
Primary Head Node
      │
      │ HA / Failover Network
      │
Secondary Head Node
두 Head Node는 서로 계속 통신하면서:
- 상태 확인
- Failover 판단
- MySQL 데이터 동기화
- Heartbeat
를 수행합니다.
그래서 Secondary에서:
mysql [FAIL]이 보이면 가장 먼저 의심할 것은:
Primary ↔ Secondary 간 통신 문제
입니다.
MySQL이 왜 나오나요?
BCM은 클러스터 설정 정보를 DB에 저장합니다.
HA 환경에서는 Primary와 Secondary 사이에서 데이터가 동기화되어야 합니다.
Primary BCM
   │
   └─ MySQL DB
        │
        │ Replication
        ▼
Secondary BCM
   └─ MySQL DB
그런데 네트워크가 끊기거나 잘못 설정되면:
Primary MySQL
     X
Secondary MySQL
처럼 replication이 정상적으로 되지 않을 수 있습니다.
그래서:
mysql [FAIL]이 나타날 수 있습니다.
특히 HA 전용 네트워크가 중요합니다
NVIDIA는 HA용으로 Primary와 Secondary Head Node NIC를 직접 연결하는 것을 강하게 권장하고, 직접 연결이 어렵다면 dedicated VLAN을 사용하도록 안내합니다. NVIDIA Docs
예:
Primary Head
   eth0
     │
     │ HA Failover Network
     │
   eth0
Secondary Head
즉 이 경로에:
- 케이블 문제
- IP 설정 오류
- VLAN 오류
- 인터페이스 Down
- Routing 문제
- Firewall 문제
등이 있으면 HA/MySQL 상태가 깨질 수 있습니다.
보기별 분석
A. NVIDIA GPU Driver 없음 ❌
Head Node의 MySQL replication 문제와 GPU Driver는 직접적인 관련이 없습니다.
B. BCM License 만료 ❌
HA 설정에는 적절한 라이선스가 필요하지만, 이미 HA 설정 후 Secondary의 mysql [FAIL]만 보이는 상황이라면 네트워크/replication 쪽이 더 직접적인 원인입니다.
C. Compute Node가 켜져 있음 ❌
Compute Node 전원 상태 때문에 Secondary MySQL이 FAIL이 되는 것은 아닙니다.
D. Primary ↔ Secondary Network 문제 ✅
MySQL replication과 HA heartbeat 모두 Head Node 간 통신에 의존합니다.
시험 암기
BCM HA + mysql FAIL → Head Node 간 Network 확인
조금 더 구체적으로:
mysql FAIL
   ↓
Replication 확인
   ↓
Primary ↔ Secondary 통신 확인
   ↓
HA NIC / IP / Cable / VLAN 점검
한 줄 요약
Question #27 정답: D ✅
특히 BCM HA에서는 mysql + ping + failoverping이 같이 중요합니다. 이 중 하나라도 FAIL이면 먼저 Primary/Secondary Head Node 간 네트워크를 의심하면 됩니다. NVIDIA Docs
===================
여기서는 cmsh와 cmha를 구분하는 게 중요합니다. 앞 문제 문장에 cmsh status라고 표현되어 있지만, **BCM HA 상태에서 mysql [FAIL], failoverping [OK] 등을 확인하는 정확한 명령은 cmha status**입니다. NVIDIA 공식 문서도 그렇게 안내합니다. NVIDIA Docs
1. cmsh가 뭐야?
cmsh = Cluster Management Shell
쉽게 말하면:
BCM(Base Command Manager)을 명령어로 관리하는 전용 관리 쉘
입니다. NVIDIA Docs
일반 Linux Shell이:
[root@bcm-head ~]#라면 여기서:
cmsh를 실행하면:
[bcm-head]%처럼 BCM 관리 모드로 들어갑니다.
이 안에서 서버, 네트워크, 이미지, 카테고리 등을 관리합니다.
cmsh
 │
 ├─ device       → 노드/장비 관리
 ├─ category     → Category 관리
 ├─ network      → 네트워크 관리
 ├─ softwareimage→ OS 이미지 관리
 └─ partition    → 클러스터/Failover 관리
NVIDIA는 cmsh를 BCM의 CLI 관리 인터페이스로 설명합니다. GUI인 Base View와 같은 클러스터 관리 기능을 제공합니다. NVIDIA Docs
2. 그럼 cmsh status는 뭐야?
여기서 조금 주의해야 합니다.
일반 노드 상태를 볼 때는 예를 들어:
cmsh -c "device status"또는 축약해서:
cmsh -c "ds"를 사용할 수 있습니다.
출력 예:
bcm-head ........ [ UP ]
node001 .......... [ UP ]
node002 .......... [ UP ]
node003 .......... [ DOWN ]
즉:
BCM이 관리하는 노드들이 살아 있는지 확인
하는 용도입니다. NVIDIA BCM 11 문서에서도 cmsh -c "ds"로 device 상태를 검증하는 예를 제공합니다. NVIDIA Docs
3. HA 상태 확인은 cmha status
Question #27에서 나온:
mysql       [ OK ]
ping        [ OK ]
failoverping[ OK ]
status      [ OK ]
를 확인하려면 더 정확한 명령은:
cmha status입니다.
예:
Node Status: running in active mode

bcm-head-01* -> bcm-head-02

failoverping [ OK ]
mysql        [ OK ]
ping         [ OK ]
status       [ OK ]
여기서 *가 붙은 노드가 현재 Active Head Node입니다. NVIDIA Docs
즉 시험에서는 이렇게 구분하세요.
| cmsh | BCM 관리 CLI 접속 |
| cmsh -c "ds" | Node/Device 상태 확인 |
| cmha status | BCM HA 상태 확인 |
| cmha makeactive | Active Head Node 전환 |
4. BCM은 항상 이중화인가?
아닙니다. ❌
BCM은 Head Node 1대로도 구성할 수 있습니다.
      BCM Head Node
           │
    ┌──────┼──────┐
    ↓      ↓      ↓
 Node01  Node02  Node03
이 구성이 정상적인 BCM 구성으로 가능합니다.
하지만 문제가 하나 있습니다.
BCM Head Node 장애
       ↓
관리 기능 장애
       ↓
Single Point of Failure
즉 Head Node 하나가 죽으면 클러스터 관리 기능에 큰 영향을 줍니다.
NVIDIA도 공식적으로 single head node 환경에서는 Head Node가 클러스터의 Single Point of Failure가 된다고 설명합니다. NVIDIA Docs
5. 그래서 HA를 구성하면 Head Node가 2대
HA를 사용하면:
┌─────────────────┐
│ Primary Head    │
│    Active       │
└───────┬─────────┘
        │
        │ HA Network
        │ MySQL Replication
        │ Heartbeat
        │
┌───────▼─────────┐
│ Secondary Head  │
│    Passive      │
└─────────────────┘
Primary가 장애 나면:
Primary ❌

        ↓ Failover

Secondary
Passive → Active ✅
가 됩니다.
NVIDIA 공식 BCM 문서도 HA에서는 Primary와 Secondary 두 Head Node 중 하나가 Active, 다른 하나가 Passive로 동작한다고 설명합니다. NVIDIA Docs
여기서 MySQL이 중요한 이유
BCM의 설정 정보가 DB에 있기 때문에:
Primary Head
   │
 MySQL
   │
 Replication
   ↓
Secondary Head
 MySQL
형태로 동기화합니다.
그래서 Question #27에서:
mysql [FAIL]이 나오면:
Primary
   X
Secondary
간 통신이나 replication 문제를 우선 의심했던 겁니다.
6. 그런데 DGX BasePOD에서는 왜 Head Node가 2대처럼 나오나요?
여기서 중요한 차이가 있습니다.
BCM 제품 자체가 반드시 HA를 요구하는 것은 아닙니다.
하지만 NVIDIA의 일부 Enterprise Reference Architecture / Mission Control / 대규모 DGX 설계에서는 안정성을 위해 BCM Head Node를 2대 HA 구성으로 설계합니다.
예를 들어 최신 NVIDIA Mission Control 아키텍처에서는:
BCM Head Nodes – x86 ×2
구성을 사용합니다. NVIDIA Docs
즉:
일반 BCM
→ Head Node 1대 가능

운영 중요도가 높은 AI Cluster
→ Head Node 2대 HA 권장/설계

일부 NVIDIA Reference Architecture
→ 처음부터 Head Node ×2
라고 이해하면 됩니다.
🎯 시험용으로 딱 정리
cmsh
Cluster Management Shell
BCM을 명령어로 관리하는 CLIcmha
BCM High Availability 관리 도구
cmha status
→ Primary / Secondary
→ mysql
→ ping
→ failoverping
→ HA 상태 확인
BCM HA
항상 HA인 것은 아니다.
BCM Head 1대
→ 가능
→ 하지만 SPOF

BCM Head 2대
→ HA
→ Active / Passive
→ 장애 시 Failover
한 줄 암기 ⭐
cmsh = BCM 전체 관리 CLI / cmha = BCM 이중화 관리 / BCM 자체는 1대도 가능하지만 중요한 DGX 클러스터에서는 2대 HA 구성을 많이 사용한다. NVIDIA Docs


댓글